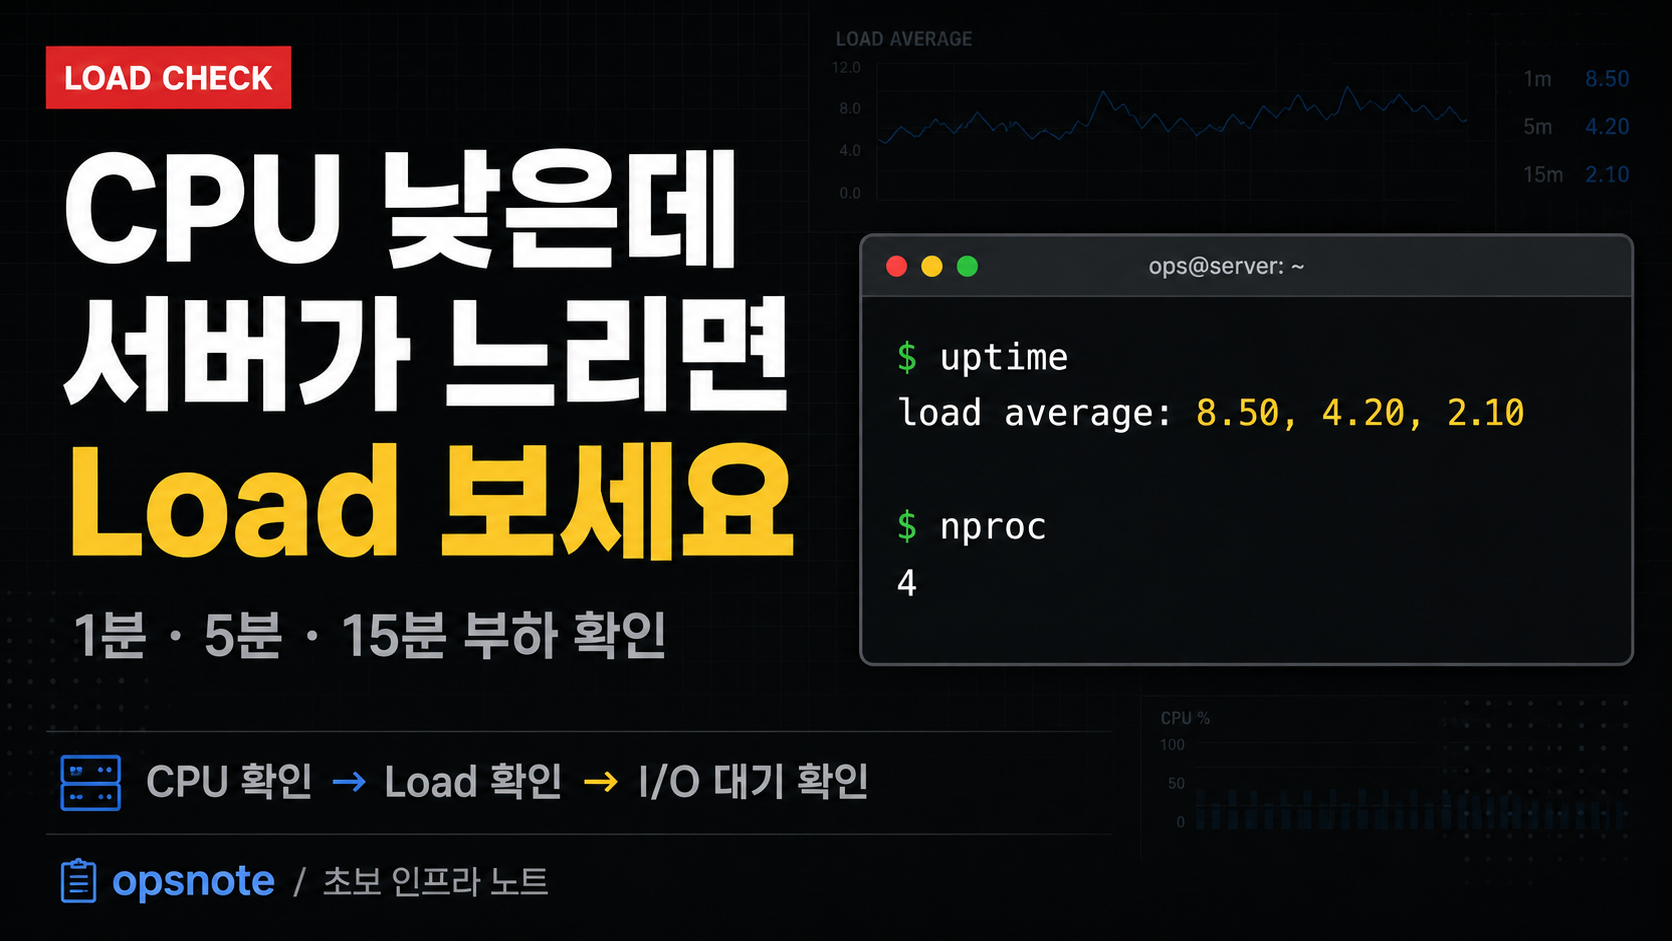
리눅스 서버가 느려졌을 때 가장 먼저 보는 것 중 하나가 CPU 사용률입니다.
top그런데 막상 top을 열어보면 CPU 사용률은 생각보다 낮은데, 서버는 계속 느린 경우가 있습니다.
처음에는 이 상황이 꽤 헷갈릴 수 있습니다.
CPU는 별로 안 쓰는 것 같은데
왜 접속은 느리지?
왜 명령어 반응이 늦지?
왜 서비스 응답이 밀리지?
이럴 때 같이 봐야 하는 값이 Load Average입니다.
Load Average는 CPU 사용률과 같은 개념이 아닙니다. 서버에서 실행 중이거나 실행을 기다리는 작업, 그리고 리눅스에서는 I/O 대기 상태에 있는 작업까지 포함해서 평균 부하를 보여주는 값에 가깝습니다.
즉, CPU 사용률이 낮아 보여도 작업들이 디스크, 스토리지, NFS, DB 응답을 기다리고 있으면 Load Average가 높게 보일 수 있습니다.
서버가 느릴 때 CPU만 보면 놓칠 수 있습니다
서버 느림 상황에서 CPU 사용률만 보고 바로 판단하면 위험합니다.
예를 들어 이런 상황이 있을 수 있습니다.
- CPU 사용률은 20% 정도로 낮음
- 그런데 Load Average는 CPU 코어 수보다 높음
- top에서 wa 값이 높음
- 특정 프로세스가 D 상태로 쌓임
- 디스크 I/O나 외부 스토리지 응답이 느림
이 경우는 CPU가 일을 많이 해서 느린 게 아니라, 작업들이 무언가를 기다리느라 밀리는 상황일 수 있습니다.
그래서 서버가 느릴 때는 CPU, 메모리, 디스크를 따로따로 보는 것보다 전체 상태를 같이 보고 정리하는 것이 좋습니다.
서버 느림 상황에서 CPU, 메모리, 디스크 상태를 보고용으로 정리하는 흐름은 아래 글과 이어서 보면 좋습니다.
https://opsnote.tistory.com/47
리눅스 서버 느림 보고할 때 CPU, 메모리, 디스크 상태 정리하는 방법
리눅스 서버가 느려졌다는 이야기를 들으면 초보 운영자는 먼저 명령어부터 떠올리게 됩니다.topfree -mdf -huptime그런데 실제 운영에서는 명령어를 실행하는 것만큼 중요한 게 하나 더 있습니다.확
opsnote.tistory.com
Load Average는 어디서 볼 수 있을까?
Load Average는 여러 명령어에서 확인할 수 있습니다.
가장 많이 보는 것은 top입니다.
top상단을 보면 이런 줄이 나옵니다.
load average: 1.20, 2.15, 3.40uptime으로도 간단히 확인할 수 있습니다.
uptime예시는 아래와 같습니다.
10:25:13 up 15 days, 3:12, 2 users, load average: 1.20, 2.15, 3.40w 명령어에서도 확인할 수 있습니다.
ww는 현재 접속 사용자와 함께 Load Average도 보여주기 때문에, 서버가 느릴 때 누가 접속해 있는지 같이 볼 때 유용합니다.
Load Average 숫자 3개는 무엇을 뜻할까?
Load Average는 보통 숫자 3개로 나옵니다.
load average: 0.85, 1.24, 2.10왼쪽부터 순서대로 아래 의미입니다.
0.85
→ 최근 1분 평균 부하

1.24
→ 최근 5분 평균 부하

2.10
→ 최근 15분 평균 부하
처음에는 숫자가 3개라서 헷갈릴 수 있습니다.
간단히 보면 이렇게 해석하면 됩니다.
1분 값만 높다
→ 최근 갑자기 부하가 올라갔을 수 있음

1분, 5분 값이 같이 높다
→ 몇 분째 부하가 이어지고 있을 수 있음

1분, 5분, 15분 값이 모두 높다
→ 부하가 꽤 오래 지속되고 있을 수 있음
예를 들어 아래처럼 나왔다고 해보겠습니다.
load average: 8.50, 4.20, 2.10최근 1분 값이 8.50으로 가장 높습니다.
이 경우는 최근에 갑자기 부하가 치솟았을 가능성이 있습니다.
반대로 아래처럼 나올 수도 있습니다.
load average: 1.00, 5.00, 8.00이 경우는 지금은 조금 내려왔지만, 15분 기준으로는 이전에 부하가 높았을 가능성이 있습니다.
Load Average는 현재 순간만 보는 값이 아니라, 부하 흐름을 보는 값이라고 생각하면 편합니다.
Load Average는 CPU 코어 수와 같이 봐야 합니다
Load Average 숫자만 보고 높다, 낮다를 바로 판단하면 안 됩니다.
반드시 CPU 코어 수와 같이 봐야 합니다.
CPU 코어 수는 아래 명령어로 확인할 수 있습니다.
nproc예를 들어 결과가 4라면 논리 CPU가 4개라는 뜻입니다.
4조금 더 자세히 보고 싶으면 lscpu를 사용할 수 있습니다.
lscpu확인할 항목은 이런 것들입니다.
CPU(s)
Core(s) per socket
Socket(s)
Thread(s) per core
초보 운영자 기준으로는 처음에는 nproc 결과를 기준으로 봐도 충분합니다.
예를 들어 CPU가 4개인 서버라면 대략 이렇게 생각할 수 있습니다.
CPU 4개 서버에서 Load Average 4 근처
→ CPU 기준으로 꽉 찬 상태에 가까울 수 있음

CPU 4개 서버에서 Load Average 8
→ 처리 대기 작업이 쌓였을 가능성

CPU 16개 서버에서 Load Average 8
→ 숫자만 보고 바로 위험하다고 단정하기 어려움
같은 Load Average 8이라도 2 CPU 서버에서는 높게 볼 수 있고, 32 CPU 서버에서는 상대적으로 여유가 있을 수 있습니다.
그래서 Load Average는 항상 CPU 개수와 같이 봐야 합니다.
CPU 사용률은 낮은데 Load Average가 높을 수 있습니다
여기서 많이 헷갈립니다.
CPU 사용률은 낮은데 Load Average가 높을 수 있습니다.
처음 보면 이상해 보입니다.
CPU는 놀고 있는 것 같은데
Load Average는 왜 높지?
이럴 때 대표적으로 의심할 수 있는 것이 I/O 대기입니다.
프로세스가 CPU를 쓰는 게 아니라 디스크, 스토리지, 네트워크 파일시스템, DB 응답을 기다리고 있을 수 있습니다.
예를 들면 이런 경우입니다.
- 디스크 I/O가 느림
- 로그 쓰기가 밀림
- 백업 작업이 디스크를 많이 사용함
- NFS 응답이 느림
- DB 쿼리 응답이 느림
- 외부 스토리지 응답이 느림
- 많은 프로세스가 I/O 대기 상태에 있음
이런 상황에서는 CPU 사용률만 보면 “괜찮아 보이는데?”라고 착각할 수 있습니다.
하지만 실제로는 작업들이 기다리는 줄에 쌓여 있을 수 있습니다.
top에서 wa 값을 같이 봐야 합니다
top을 실행하면 Load Average 말고도 CPU 라인을 같이 봐야 합니다.
top상단에 이런 줄이 보일 수 있습니다.
%Cpu(s): 5.0 us, 2.0 sy, 0.0 ni, 80.0 id, 13.0 wa여기서 초보 운영자가 특히 봐야 할 값은 wa입니다.
wa
→ I/O wait
wa는 CPU가 디스크나 스토리지 I/O를 기다리는 시간으로 볼 수 있습니다.
예를 들어 이런 조합이라면 I/O 대기를 의심할 수 있습니다.
CPU 사용률은 낮음
Load Average는 높음
wa 값이 높음
서버 반응이 느림
이때 바로 CPU 문제라고 단정하면 안 됩니다.
디스크 I/O, NFS, 외부 스토리지, DB 응답 지연 같은 쪽을 같이 봐야 합니다.
프로세스 상태도 같이 봅니다
Load Average가 높을 때는 어떤 프로세스가 쌓여 있는지도 봐야 합니다.
CPU 사용률 기준으로 상위 프로세스를 볼 수 있습니다.
ps -eo pid,ppid,cmd,%cpu,%mem --sort=-%cpu | head메모리 기준으로 보고 싶다면 아래처럼 확인합니다.
ps -eo pid,ppid,cmd,%cpu,%mem --sort=-%mem | head그런데 Load Average가 높다고 해서 항상 CPU를 많이 쓰는 프로세스가 보이는 것은 아닙니다.
작업들이 CPU를 쓰는 중이 아니라 I/O를 기다리는 상태라면 CPU 정렬에서는 잘 안 보일 수 있습니다.
이럴 때는 프로세스 상태값도 같이 봅니다.
ps -eo pid,stat,cmd | head자주 보는 상태는 대략 이렇습니다.
R
→ 실행 중 또는 실행 대기

S
→ 대기 상태

D
→ I/O 대기 상태

Z
→ 좀비 프로세스
특히 D 상태가 많이 보이면 디스크나 스토리지 I/O 대기를 의심할 수 있습니다.
다만 여기서 바로 kill을 치면 안 됩니다.
D 상태 프로세스가 어떤 작업인지, 정상 배치인지, 서비스 프로세스인지 먼저 확인해야 합니다.
CPU가 높은 PID를 찾고 바로 죽이지 말아야 하는 이유는 아래 글과 이어서 보면 좋습니다.
https://opsnote.tistory.com/45
리눅스 서버 CPU 100% 알림 떴을 때, 재기동 전 범인(PID)부터 찾는 법
리눅스 서버가 갑자기 느려졌을 때 가장 먼저 의심하는 것 중 하나가 CPU 사용률입니다.서버가 버벅이거나, 접속이 느려지거나, 서비스 응답이 늦어질 때 top을 열어보면 특정 프로세스가 CPU를 많
opsnote.tistory.com
iostat로 디스크 I/O를 확인합니다
Load Average가 높고 wa 값도 높다면 디스크 I/O 상태를 봐야 합니다.
가능하다면 iostat를 사용할 수 있습니다.
iostat -xz 1 3iostat는 환경에 따라 기본 설치되어 있지 않을 수 있습니다. 보통 sysstat 패키지에 포함됩니다.
여기서 초보 운영자 기준으로 볼 만한 값은 아래입니다.
%util
→ 디스크가 얼마나 바쁘게 사용되는지

await
→ I/O 요청이 처리되기까지 걸리는 평균 시간

r/s, w/s
→ 초당 읽기/쓰기 요청 수

rkB/s, wkB/s
→ 초당 읽기/쓰기 데이터량
처음부터 모든 값을 해석하려고 하면 피곤합니다.
처음에는 이렇게만 봐도 됩니다.
Load Average 높음
wa 높음
iostat에서 await 높음 또는 %util 높음
→ 디스크 I/O 지연 가능성
iostat가 없다면 vmstat로도 흐름을 볼 수 있습니다.
vmstat 1 5여기서 wa, bi, bo 등을 같이 볼 수 있습니다.
wa
→ I/O wait

bi
→ block in

bo
→ block out
df -h로 디스크 사용률도 확인합니다
디스크 I/O만 볼 것이 아니라 디스크 용량도 같이 봐야 합니다.
df -h특정 경로가 가득 차 있으면 로그 쓰기, 임시 파일 생성, 애플리케이션 동작에 영향을 줄 수 있습니다.
예를 들어 /var나 /tmp가 꽉 찬 상황이라면 서비스가 느려지거나 오류가 날 수 있습니다.
df -h /var
df -h /tmp
서버가 느린 상황에서는 디스크 용량, I/O, 로그 증가를 같이 보는 것이 좋습니다.
단순히 CPU가 낮다고 해서 정상이라고 보면 안 됩니다.
메모리와 Swap도 같이 확인합니다
서버 느림 상황에서는 메모리와 Swap도 함께 확인해야 합니다.
free -m여기서 used만 보면 안 됩니다.
available을 같이 봐야 합니다.
리눅스는 캐시 때문에 used가 높게 보일 수 있습니다. 그래서 실제 판단에서는 available을 같이 봐야 합니다.
메모리 상태를 볼 때 used만 보고 판단하면 틀릴 수 있는 이유는 아래 글에서 따로 정리했습니다.
https://opsnote.tistory.com/44
리눅스 서버 메모리 used만 보면 판단이 틀리는 이유와 available 확인법
리눅스 서버에서 메모리 상태를 확인할 때 가장 많이 쓰는 명령어 중 하나가 free -m입니다.free -m그런데 초보 운영자 입장에서 가장 헷갈리는 부분이 있습니다.used 값이 높게 보이면 바로 “메모
opsnote.tistory.com
Swap도 같이 봅니다.
free -m
vmstat 1 5
Swap 사용량이 있다고 무조건 문제는 아닙니다.
중요한 것은 현재도 Swap in, Swap out이 계속 발생하는지입니다.
Swap이 올라갔다고 바로 재기동하지 말고 확인하는 흐름은 아래 글과 이어서 보면 좋습니다.
https://opsnote.tistory.com/43
리눅스 서버 Swap 올라갔다고 바로 재기동하지 말고 확인하는 순서
리눅스 서버를 확인하다 보면 free -m 결과에서 Swap 사용량이 높게 보일 때가 있습니다.초보 운영자 입장에서는 이 숫자를 보면 바로 불안해집니다.free -m예를 들어 이런 식입니다. total used free share
opsnote.tistory.com
서비스 로그도 같이 봐야 합니다
Load Average가 높고 서버가 느릴 때는 OS 지표만 볼 것이 아니라 서비스 로그도 확인해야 합니다.
서비스가 systemd로 관리된다면 journalctl을 볼 수 있습니다.
journalctl -u nginx -n 100 --no-pager서비스 상태는 아래처럼 확인합니다.
systemctl status nginx --no-pager애플리케이션 로그가 따로 있다면 최근 로그도 확인합니다.
tail -n 100 /app/logs/service.log로그에서 확인할 키워드는 상황에 따라 다르지만, 예를 들면 아래와 같습니다.
timeout
slow
error
exception
connection refused
database
disk
no space
서비스 로그 확인은 아래 글에서 자세히 정리했습니다.
https://opsnote.tistory.com/33
리눅스 서버 서비스 장애 났을 때 journalctl로 systemd 로그 확인하는 법
서비스가 안 뜨거나, 재기동은 됐는데 정상 동작이 아닌 것 같을 때 초보자가 흔히 하는 실수 중 하나가 로그 파일 경로부터 먼저 헤매는 것입니다.리눅스 서버에서 systemd로 관리되는 서비스라
opsnote.tistory.com
서비스 상태 확인은 아래 글과 이어서 보면 좋습니다.
https://opsnote.tistory.com/27
리눅스 서버 서비스가 안 뜰 때 재기동부터 하지 말고 systemctl status 먼저 확인하는 법
리눅스 서버를 운영하다 보면 “서비스가 안 떠요”, “접속이 안 됩니다”, “프로세스가 죽은 것 같습니다” 같은 상황을 만날 수 있습니다.이럴 때 초보 운영자 입장에서 가장 먼저 떠오르는
opsnote.tistory.com
Load Average가 높을 때 바로 재기동하면 안 되는 이유
서버가 느리고 Load Average가 높으면 바로 재기동하고 싶어질 수 있습니다.
하지만 여기서 바로 재기동하면 원인 단서가 사라질 수 있습니다.
예를 들어 이런 정보가 없어질 수 있습니다.
- 어떤 프로세스가 많았는지
- wa 값이 높았는지
- D 상태 프로세스가 있었는지
- 디스크 I/O가 밀렸는지
- 특정 시간대 로그가 반복됐는지
- 어떤 배치나 백업이 돌고 있었는지
재기동은 증상을 잠깐 없앨 수는 있습니다.
하지만 왜 느려졌는지는 놓칠 수 있습니다.
특히 반복적으로 느려지는 서버라면 재기동보다 원인 확인이 먼저입니다.
서버 재기동 전 전체 체크리스트는 아래 글에서 볼 수 있습니다.
https://opsnote.tistory.com/19
리눅스 서버 재기동 전 바로 껐다 켜지 말고 확인해야 할 체크리스트
리눅스 서버가 느려졌거나 서비스가 이상할 때, 가장 먼저 떠오르는 조치가 재기동일 때가 있습니다. 서버를 재기동하면 일단 문제가 해결되는 것처럼 보일 수 있습니다. 하지만 운영 서버에서
opsnote.tistory.com
Load Average가 높을 때 확인 순서
초보 운영자 기준으로는 아래 순서가 무난합니다.
1. uptime 또는 top으로 Load Average 확인
2. nproc 또는 lscpu로 CPU 개수 확인
3. top에서 CPU 사용률과 wa 값 확인
4. ps로 의심 프로세스 확인
5. D 상태 프로세스가 많은지 확인
6. iostat 또는 vmstat로 I/O 상태 확인
7. df -h로 디스크 사용률 확인
8. free -m과 vmstat로 메모리, Swap 확인
9. systemctl status로 서비스 상태 확인
10. journalctl 또는 애플리케이션 로그 확인
11. 조치 전 영향도 판단
명령어로 정리하면 아래와 같습니다.
uptime
nproc
lscpu
top
ps -eo pid,stat,cmd,%cpu,%mem --sort=-%cpu | head
ps -eo pid,stat,cmd | grep ' D '
iostat -xz 1 3
vmstat 1 5
df -h
free -m
systemctl status nginx --no-pager
journalctl -u nginx -n 100 --no-pager
이렇게 보면 단순히 “CPU가 높다 낮다”가 아니라, 서버가 왜 느려졌는지 방향을 잡을 수 있습니다.
결과를 어떻게 해석하면 좋을까?
몇 가지 상황별로 나눠보면 이해가 쉽습니다.
Load Average 높음 + CPU 사용률 높음
→ CPU를 많이 쓰는 프로세스 확인

Load Average 높음 + CPU 사용률 낮음 + wa 높음
→ 디스크 I/O 또는 스토리지 대기 의심

Load Average 높음 + D 상태 프로세스 많음
→ I/O 대기 또는 외부 스토리지 응답 지연 의심

Load Average 높음 + 메모리 available 낮음 + Swap in/out 발생
→ 메모리 압박 가능성

Load Average 높음 + 로그에 timeout 반복
→ 외부 연동, DB, API 응답 지연 가능성
여기서 바로 결론을 내리기보다, 서로 맞물리는 증거를 모으는 것이 좋습니다.
운영에서는 지표 하나보다 조합이 중요합니다.
실무 보고 예시
Load Average를 확인한 뒤에는 이렇게 정리할 수 있습니다.
서버 상태 확인 결과, CPU 사용률은 높지 않으나 Load Average가 CPU 개수 대비 높은 상태로 확인됩니다.
top 기준 wa 값과 디스크 I/O 상태를 추가 확인하겠습니다.
I/O 대기가 의심된다면 이렇게 쓸 수 있습니다.
Load Average 상승과 함께 CPU wa 값이 높게 확인되어,
CPU 부하보다는 디스크 I/O 대기 가능성이 있습니다.
iostat 및 D 상태 프로세스를 추가 확인하겠습니다.
CPU 사용 프로세스가 보이면 이렇게 정리할 수 있습니다.
Load Average 상승 시점에 특정 프로세스의 CPU 사용률이 높게 확인되었습니다.
해당 프로세스의 작업 내용과 서비스 영향도를 확인한 뒤 조치 여부를 판단하겠습니다.
Swap까지 같이 보인다면 이렇게 쓸 수 있습니다.
Load Average 상승과 함께 available 메모리가 낮고 Swap in/out이 확인됩니다.
메모리 압박 가능성이 있어 주요 프로세스 메모리 사용량과 애플리케이션 로그를 추가 확인하겠습니다.
원인이 아직 불명확할 때는 이렇게 정리합니다.
현재 Load Average는 높게 확인되나 단일 지표만으로 원인을 확정하기는 어렵습니다.
CPU, I/O wait, 디스크 사용률, 프로세스 상태, 서비스 로그를 순서대로 확인하겠습니다.
이렇게 쓰면 단순히 “서버 느립니다”보다 훨씬 명확합니다.
정리하면
서버가 느릴 때 CPU 사용률만 보고 판단하면 놓치는 부분이 있습니다.
CPU는 낮은데 서버가 느리다면 Load Average를 같이 봐야 합니다.
기본 확인 명령어는 아래입니다.
uptime
top
w
CPU 개수는 아래처럼 확인합니다.
nproc
lscpu
Load Average가 높을 때는 wa, 프로세스 상태, 디스크 I/O, 메모리, Swap, 로그를 함께 봐야 합니다.
top
ps -eo pid,stat,cmd,%cpu,%mem --sort=-%cpu | head
iostat -xz 1 3
vmstat 1 5
df -h
free -m
journalctl -u nginx -n 100 --no-pager
초보 운영자라면 이 문장만 기억해도 좋습니다.
CPU가 낮다고 정상이라 하지 말고 Load Average까지 확인하세요.
단, Load Average가 높다고 바로 CPU 문제로 단정하면 안 됩니다.
서버 느림 확인도 결국 같습니다.
확인 → 판단 → 조치 → 재확인
서버가 느릴 때 CPU 사용률만 보고 판단하면 놓치는 부분이 있습니다.
CPU는 낮은데 서버가 느리다면 Load Average를 같이 봐야 합니다.
다만 Load Average가 높다고 바로 CPU 문제로 단정하면 안 됩니다. wa, 프로세스 상태, 디스크 I/O, 메모리, Swap, 로그를 함께 봐야 합니다.
top에서 wa 값이 높게 보일 때 확인하는 방법은 아래 글에서 이어서 볼 수 있습니다.
https://opsnote.tistory.com/42
리눅스 서버 CPU 낮다고 정상이라 하지 말고 top wa 값까지 확인하는 법
리눅스 서버가 느려졌을 때 top 명령어를 열어보면 보통 CPU 사용률부터 보게 됩니다.top 그런데 CPU 사용률은 높지 않은데 서버가 계속 느린 경우가 있습니다.처음에는 이렇게 생각하기 쉽습니다.C
opsnote.tistory.com
서버가 느릴 때 CPU, 메모리, 디스크 상태를 함께 보고하는 흐름은 아래 글에서 정리했습니다.
https://opsnote.tistory.com/47
리눅스 서버 느림 보고할 때 CPU, 메모리, 디스크 상태 정리하는 방법
리눅스 서버가 느려졌다는 이야기를 들으면 초보 운영자는 먼저 명령어부터 떠올리게 됩니다.topfree -mdf -huptime그런데 실제 운영에서는 명령어를 실행하는 것만큼 중요한 게 하나 더 있습니다.확
opsnote.tistory.com
리눅스 서버 장애 대응 전체 흐름은 아래 글에서 함께 보면 좋습니다.
https://opsnote.tistory.com/69
초보 운영자를 위한 리눅스 서버 장애 대응 순서 총정리
리눅스 서버를 운영하다 보면 어느 날 갑자기 이런 말을 듣게 됩니다.서버가 느립니다.접속이 안 됩니다.서비스가 안 뜹니다.디스크가 가득 찼습니다.로그가 계속 쌓입니다.재기동하면 될까요?
opsnote.tistory.com
'리눅스' 카테고리의 다른 글
| 리눅스 서버 Swap 올라갔다고 바로 재기동하지 말고 확인하는 순서 (0) | 2026.06.20 |
|---|---|
| 리눅스 서버 CPU 낮다고 정상이라 하지 말고 top wa 값까지 확인하는 법 (0) | 2026.06.19 |
| 리눅스 서버 nslookup만 보지 말고 dig로 DNS 응답까지 확인하는 법 (0) | 2026.06.17 |
| 리눅스 서버 도메인 안 된다고 서버부터 보지 말고 nslookup으로 DNS부터 확인하는 법 (0) | 2026.06.16 |
| 리눅스 서버 접속 확인할 때 curl과 nc 차이, 포트와 HTTP 응답을 구분하는 법 (1) | 2026.06.15 |