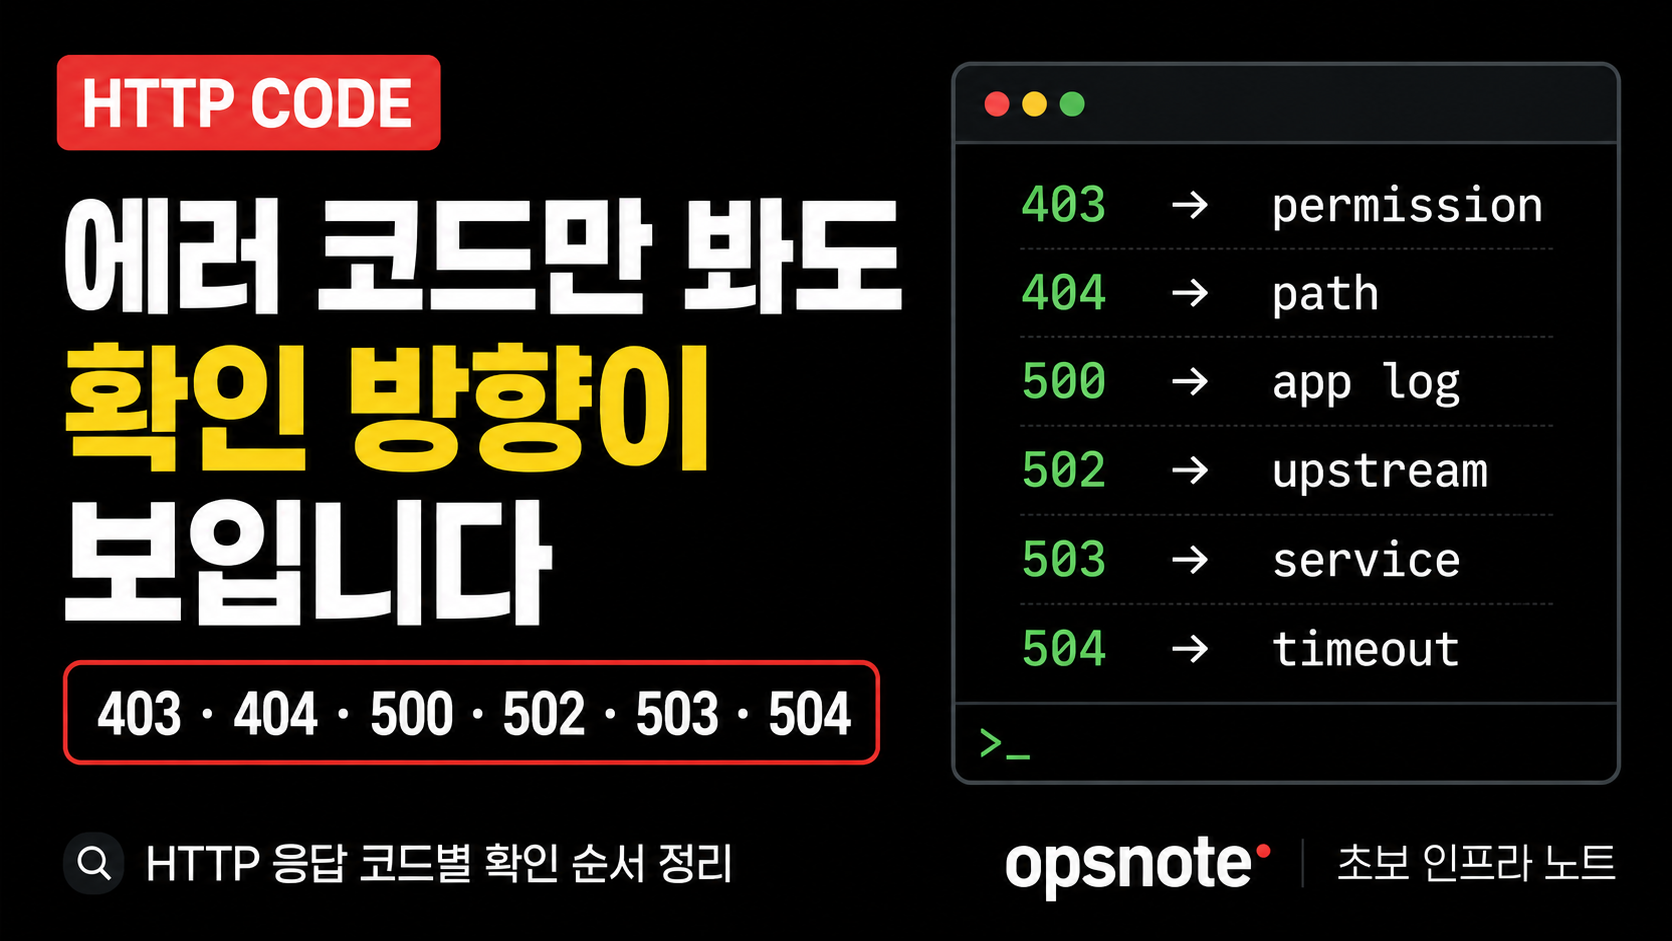
리눅스 서버에서 웹 장애가 발생했을 때 브라우저에 403, 404, 500, 502, 503, 504 같은 HTTP 응답 코드가 뜨면 처음에는 다 비슷한 오류처럼 보입니다. 하지만 서버 운영에서는 에러 코드만 잘 봐도 권한 문제인지, 경로 문제인지, 애플리케이션 오류인지, 응답 지연인지 확인 방향을 잡을 수 있습니다. 이번 글에서는 초보 운영자 기준으로 HTTP 상태코드별 확인 순서를 정리해보겠습니다.
HTTP 응답 코드를 먼저 봐야 하는 이유
장애가 났을 때 초보 운영자는 보통 이렇게 생각하기 쉽습니다.
사이트가 안 된다
서버가 죽은 것 같다
nginx 재기동해야 하나?
방화벽 문제인가?
하지만 HTTP 코드를 보면 처음부터 조금 더 좁혀서 볼 수 있습니다.
403 → 접근이 막힘
404 → 경로를 못 찾음
500 → 애플리케이션 내부 오류
502 → 앞단과 뒤쪽 서버 연결 문제
503 → 서비스가 요청을 받을 준비가 안 됨
504 → 뒤쪽 응답이 늦어서 timeout
즉, HTTP 응답 코드는 장애 상황에서 방향표지판 같은 역할을 합니다.
물론 코드 하나만 보고 원인을 확정할 수는 없지만, 어디부터 확인할지를 정하는 데는 큰 도움이 됩니다.
먼저 curl로 상태코드 확인하기
브라우저 화면만 보고 판단하지 말고, 먼저 curl로 상태코드를 확인합니다.
curl -I http://example.com특정 경로가 문제라면 해당 URL도 직접 확인합니다.
curl -I http://example.com/admin
curl -I http://example.com/api/users
curl -I http://example.com/static/app.js
예시 결과입니다.
HTTP/1.1 404 Not Found
Server: nginx
여기서 볼 것은 두 가지입니다.
1. 실제 HTTP 상태코드
2. 응답을 준 서버 정보
브라우저 화면만 보면 “안 된다”로 뭉뚱그려 보이지만, curl로 보면 403인지 404인지 500인지 구분할 수 있습니다.
403 Forbidden은 권한과 접근 정책부터 보기
403 Forbidden은 요청을 받았지만 접근이 막힌 상태에 가깝습니다.
먼저 볼 것은 권한과 접근 제한 설정입니다.
curl -I http://example.com/admin
grep -R "deny" /etc/nginx/
grep -R "allow" /etc/nginx/
ls -l /var/www/html
namei -l /var/www/html/index.html
tail -n 100 /var/log/nginx/error.log
403에서 자주 보는 원인은 다음과 같습니다.
파일 권한 문제
디렉터리 권한 문제
nginx allow / deny 설정
Apache Require 설정
index 파일 없음
SELinux 정책 차단
초보 운영자가 특히 조심해야 할 것은 chmod -R 777입니다.
chmod -R 777 /var/www/html이런 방식은 당장 접속이 되는 것처럼 보일 수 있지만, 운영 서버에서는 보안상 더 큰 문제가 될 수 있습니다.
403은 크게 열기보다 필요한 권한만 정확히 주는 방향으로 봐야 합니다.
404 Not Found는 URL과 파일 경로부터 보기
404 Not Found는 요청한 경로를 찾지 못했다는 뜻입니다.
서버가 죽었다기보다, URL 경로, 정적 파일 위치, nginx location, 애플리케이션 라우팅 문제일 수 있습니다.
curl -I http://example.com/test
grep -R "location" /etc/nginx/
grep -R "root" /etc/nginx/
grep -R "try_files" /etc/nginx/
ls -l /var/www/html
tail -n 100 /var/log/nginx/access.log
404에서 자주 보는 원인은 다음과 같습니다.
URL 오타
대소문자 차이
정적 파일 배포 누락
nginx root 경로 불일치
try_files 설정 누락
애플리케이션 라우팅 경로 변경
404는 서버가 응답을 하고 있는 상태일 가능성이 큽니다.
그래서 바로 재기동하기보다 “요청한 경로가 실제로 있는지”를 먼저 보는 게 좋습니다.
500 Internal Server Error는 애플리케이션 로그부터 보기
500 Internal Server Error는 서버 내부 처리 중 오류가 발생한 상태입니다.
겉으로는 nginx 화면에 보일 수 있지만, 실제 원인은 WAS나 애플리케이션 내부에 있을 가능성이 큽니다.
curl -I http://example.com/api/users
tail -n 100 /var/log/nginx/error.log
tail -n 200 /app/logs/application.log
journalctl -u example-app -n 100 --no-pager
500에서 자주 보는 원인은 다음과 같습니다.
애플리케이션 예외
DB 연결 실패
환경변수 누락
설정 파일 오류
파일 쓰기 권한 문제
배포 오류
리소스 부족
500은 “웹서버가 문제다”보다 “안쪽에서 처리 중 문제가 났다”에 가깝습니다.
그래서 nginx 재기동보다 애플리케이션 로그 확인이 먼저입니다.
502 Bad Gateway는 upstream 연결부터 보기
502 Bad Gateway는 앞단 서버가 뒤쪽 서버와 제대로 통신하지 못할 때 자주 발생합니다.
nginx가 요청을 받았지만, 뒤쪽 WAS나 애플리케이션 서버로 넘기는 과정에서 실패한 상황일 수 있습니다.
curl -I http://example.com
grep -R "proxy_pass" /etc/nginx/
grep -R "upstream" /etc/nginx/
ss -lntp | grep 8080
tail -n 100 /var/log/nginx/error.log
502에서 자주 보는 원인은 다음과 같습니다.
upstream 포트 미기동
애플리케이션 프로세스 종료
proxy_pass 대상 오류
Connection refused
upstream 연결 실패
502는 nginx 화면에 뜨더라도 nginx 자체가 원인이라고 단정하면 안 됩니다.
nginx가 어디로 요청을 넘기고 있는지부터 확인해야 합니다.
503 Service Unavailable은 서비스 상태부터 보기
503 Service Unavailable은 서비스가 지금 요청을 받을 준비가 안 된 상태일 수 있습니다.
특히 애플리케이션 배포 중, 서비스 기동 실패, 포트 미오픈, 헬스체크 실패 때 자주 볼 수 있습니다.
curl -I http://example.com
systemctl status example-app
ps -ef | grep example-app
ss -lntp | grep 8080
journalctl -u example-app -n 100 --no-pager
503에서 자주 보는 원인은 다음과 같습니다.
서비스가 내려감
프로세스 없음
포트가 열려 있지 않음
배포 중
헬스체크 실패
upstream 서버 전체 unavailable
503은 “서비스 상태 확인”이 먼저입니다.
바로 nginx 재기동으로 가기보다 실제 애플리케이션이 떠 있는지, 포트가 열려 있는지 봐야 합니다.
504 Gateway Timeout은 응답 지연부터 보기
504 Gateway Timeout은 앞단 서버가 뒤쪽 서버 응답을 기다리다가 시간 초과된 상태입니다.
이때는 단순 연결 실패보다 응답 지연을 먼저 의심해야 합니다.
curl -I http://example.com/api/report
curl -w "time_total: %{time_total}\n" -o /dev/null -s http://example.com/api/report
tail -n 100 /var/log/nginx/error.log
grep -R "proxy_read_timeout" /etc/nginx/
504에서 자주 보는 원인은 다음과 같습니다.
애플리케이션 처리 지연
DB 쿼리 지연
외부 API 응답 지연
upstream timed out
timeout 설정 부족
CPU, 메모리, 디스크 I/O 부족
504는 “어디서 늦어지는지”가 핵심입니다.
timeout 값을 무작정 늘리기보다, 어떤 요청이 몇 초 동안 지연되는지 먼저 확인해야 합니다.
각 HTTP 상태코드는 보는 방향이 조금씩 다릅니다. 500, 502, 503, 504처럼 앞단과 뒤쪽 서버가 함께 얽히는 오류는 이전 글들을 함께 보면 장애 대응 흐름을 잡는 데 도움이 됩니다.HTTP 코드별 확인 방향 요약
정리하면 이렇게 볼 수 있습니다.
403 Forbidden
→ 권한, 접근 정책, allow/deny, 파일/디렉터리 권한

404 Not Found
→ URL 경로, location, root, 정적 파일, 라우팅

500 Internal Server Error
→ 애플리케이션 로그, 예외, DB 연결, 설정 누락

502 Bad Gateway
→ upstream 연결, proxy_pass, 포트, WAS 프로세스

503 Service Unavailable
→ 서비스 상태, 프로세스, 포트, 헬스체크

504 Gateway Timeout
→ 응답 지연, timeout, DB 지연, 외부 API 지연
이렇게만 나눠도 장애 대응할 때 훨씬 덜 흔들립니다.
운영 서버에서 조심할 점
HTTP 오류가 뜰 때 바로 아래 작업부터 하는 건 조심해야 합니다.
systemctl restart nginx
systemctl restart example-app
kill -9 <PID>
chmod -R 777 /var/www/html
이 명령어들이 항상 틀렸다는 뜻은 아닙니다.
다만 원인을 모른 채 실행하면 정상 요청까지 끊기거나, 보안 설정이 약해지거나, 로그 단서가 사라질 수 있습니다.
운영 서버에서는 먼저 이렇게 보는 게 안전합니다.
1. HTTP 상태코드 확인
2. 영향 범위 확인
3. 웹서버 로그 확인
4. 애플리케이션 로그 확인
5. 서비스 상태와 포트 확인
6. 최근 배포와 설정 변경 확인
7. 필요한 조치만 적용
정리하면
HTTP 응답 코드는 단순한 숫자가 아니라 장애 대응의 첫 방향표입니다.
403은 권한
404는 경로
500은 애플리케이션 로그
502는 upstream 연결
503은 서비스 상태
504는 응답 지연403은 권한과 접근 정책, 404는 경로와 파일 위치, 500은 애플리케이션 로그, 502는 upstream 연결, 503은 서비스 상태, 504는 응답 지연과 timeout을 먼저 확인하면 장애 대응이 훨씬 덜 흔들립니다.
웹 장애 상황을 보고할 때 HTTP 코드와 확인 내용을 어떻게 정리하면 좋은지는 아래 글에서 이어서 볼 수 있습니다.
https://opsnote.tistory.com/64
리눅스 서버 웹 장애 보고할 때 HTTP 코드 정리하는 법, 한눈에 보이는 오류 보고 가이드
리눅스 서버 운영을 하다 보면 웹 장애가 났을 때 “사이트 안 됩니다”, “접속이 안 돼요”, “nginx 에러 같아요”처럼 너무 크게 뭉뚱그려서 보고하게 될 때가 있습니다. 그런데 실제 장애 대
opsnote.tistory.com
'리눅스' 카테고리의 다른 글
| 리눅스 서버 df와 du 결과가 다르게 보일 때 deleted 파일부터 확인하는 법 (0) | 2026.07.09 |
|---|---|
| 리눅스 서버 웹 장애 보고할 때 HTTP 코드 정리하는 법, 한눈에 보이는 오류 보고 가이드 (0) | 2026.07.08 |
| 리눅스 서버 504 Gateway Timeout 뜰 때 응답 지연부터 확인하는 법 (0) | 2026.07.06 |
| 리눅스 서버 503 Service Unavailable 뜰 때 서비스 상태부터 확인하는 법 (1) | 2026.07.05 |
| 리눅스 서버 500 Internal Server Error 뜰 때 애플리케이션 로그부터 확인하는 법 (0) | 2026.07.05 |